はじめに
こんにちは。サイバーエージェント SGEコア技術本部、グラフィックスチームの清原です。
今回は、私たちが公開しているオープンソースの Unity 向けデカールライブラリ Air Sticker のメジャーアップデート、2.0 をリリースしましたので、その目玉である高速化についてお話しします。
Air Sticker は、弾痕・足あと・汚れといった「デカール(貼り付け表現)」を実行時に生成するライブラリです。URP の Decal 機能のような投影(プロジェクション)方式ではなく、レシーバー側のモデルに沿ったメッシュをその場で生成して貼り付けるのが最大の特徴です。この方式のおかげで、URP でもビルトインレンダーパイプラインでも動き、スキン(アニメーション)メッシュにも追従し、ユーザー任意のマテリアルを使えます。その代わり、貼り付けのたびにメッシュを生成するコストがかかり、デカールが出るまでに数フレームを要します。
2.0 では、この「メッシュ生成処理」を Unity の Job System と Burst で全面的に書き直しました。本記事では、1本のスレッドで順番にこなしていた重い計算を、〈データの組み替え → 並列化 → SIMD〉という3段階でどう速くしていったかをご紹介します。
デカール生成はどこが重いのか
デカールを1枚貼るとき、Air Sticker はレシーバーオブジェクトに対しておおよそ次の処理を順番に行います。
- スキニング … レシーバーメッシュの各頂点にボーン行列を適用し、その瞬間のワールド座標を求める
- ブロードフェーズ … デカールボックスに近い三角形だけをざっくり選り分ける(明らかに無関係な面を捨てる)
- クリップ … 生き残った三角形を、デカールボックスを構成する6枚の平面で切り抜く
- メッシュ構築 … 切り抜いた多角形を三角形に展開し、UV やタンジェントを計算してメッシュにする
これらはメインスレッドを止めないよう、従来は ThreadPool のワーカースレッド1本にまとめて逃がしていました。ところがレシーバーが大きなスキンメッシュになると、頂点1つずつにボーン行列を4本ブレンドし、何万という三角形を1本のスレッドで順番にさばくことになります。ここが「デカールが出るまでのフレーム数」を決める主コストでした。
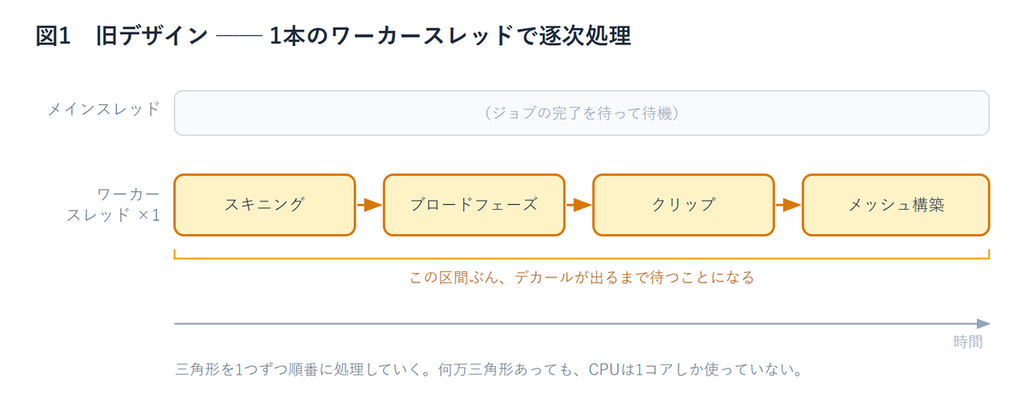
このように、デカール生成の処理は1コアしか使っていませんでした。しかし、Air Stickerの三角形ごとの処理は互いに独立しており依存関係はありません。そこで2.0のメジャーバージョンアップでUnityのJob Sysytemを活用して、複数コアを使用し処理の並列実行性を高める対応を行いました。
データの組み替え ── Job System に載せる準備
Unity の Job System を使う場合、ジョブに渡せるデータにはいくつかの制約があります。クラス(参照型)やマネージドオブジェクトを持ち込めず、値型だけで構成された blittable なデータでなければなりません。
旧実装のデータは、ポリゴンは ConvexPolygon というクラスで表現され、位置・法線・ボーンウェイトを配列で抱えつつ、レシーバーの Rendererコンポーネントへの参照を握っていました。これでは Job System に載りません。
// 変更前:ポリゴンはクラス。Component への参照を握っていて、ジョブに載せられない
public sealed class ConvexPolygon
{
    private readonly Vector3[]    _positionInWorldSpaceBuffer;
    private readonly Vector3[]    _normalInWorldSpaceBuffer;
    private readonly BoneWeight[] _boneWeightBuffer;
    private readonly Component    _receiverComponent;   // マネージド参照 → ジョブに持ち込めない
    // …
}
そこで、これらを SoA(Structure of Arrays) に組み替えました。位置・法線・ボーンウェイトを、それぞれ NativeArray の連続した配列としてフラットに並べ直し、Renderer への参照は「レシーバーの何番目のコンポーネントか」という整数のインデックスに置き換えます。これでジョブからマネージド参照が消えます。
// 変更後:値型だけの SoA。すべて NativeArray の連続配列で、参照は整数インデックスに
internal sealed class ReceiverConvexPolygonsMesh
{
    // 頂点ごと(三角形数 × 3):モデル空間の位置・法線・ボーンウェイト
    public NativeArray<float3>     SourcePositionsMs;
    public NativeArray<float3>     SourceNormalsMs;
    public NativeArray<BoneWeight> SourceBoneWeights;

    // 三角形ごと:所属するレシーバーコンポーネントの「番号」(Component 参照の置き換え)
    public NativeArray<int>  TriangleComponentIndices;
    public NativeArray<bool> ComponentIsSkinned;
}
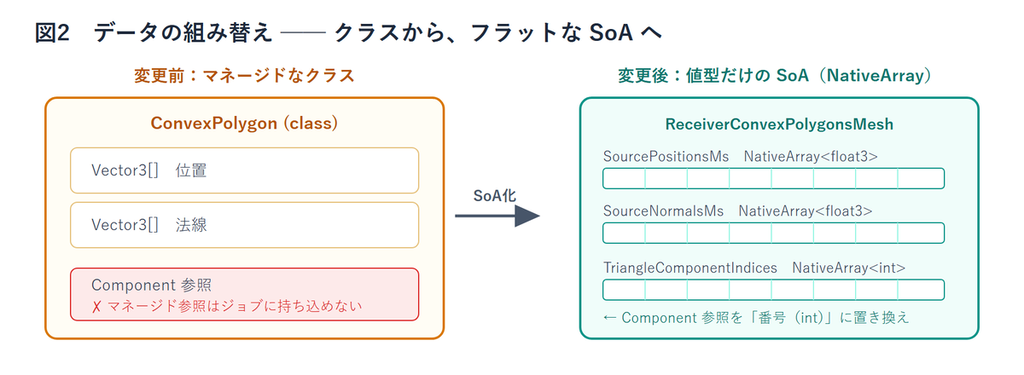
元々、並列処理化しやすいデータ構造になっていたため、各種配列をManaged型からNative型に変更しただけになります。
並列化する ── IJobParallelFor
データが blittable な配列になれば、あとは並列化です。三角形ごとの処理は互いに独立しているので、Unity の IJobParallelFor を使えば「三角形の本数だけ仕事を割り、空いているワーカースレッドに自動で分配する」ことができます。
処理は大きく3つのジョブにまとめました。
- スキニング+ブロードフェーズを融合したジョブ(三角形単位で並列)
- 6平面クリップのジョブ(三角形単位で並列)
- メッシュ構築のジョブ(メインスレッドを止めないよう、別スレッドで実行)
変更前は、ThreadPool のワーカースレッド 1本が、全ポリゴンを for ループで順番にさばいていました。
// 変更前:ワーカースレッド 1 本で、全ポリゴンを for ループで逐次処理
ThreadPool.QueueUserWorkItem(_ =>
{
    for (var i = 0; i < _convexPolygonInfos.Count; i++)         // ← 1 つずつ順番に
        _convexPolygonInfos[i].ConvexPolygon
            .CalculatePositionsAndNormalsInWorldSpace(boneMatricesPallet, /* … */);

    // 続くブロードフェーズ → クリップ → メッシュ構築も、同じ 1 本のスレッドで逐次
    _broadPhaseConvexPolygonInfos = BroadPhaseConvexPolygonsDetection.Execute(/* … */);
    SplitConvexPolygonsByPlanes();
    AddTrianglePolygonsToDecalMeshFromConvexPolygons(/* … */);
});
while (_executeLaunchingOnWorkerThread) yield return null;      // フラグが下りるのを待つ
変更後は、ループの中身を「三角形1つ分」の Execute に切り出して IJobParallelFor にし、Schedule に本数を渡すだけです。空いているコアへ Job System が自動で分配してくれます。
// 変更後:ループの中身を「三角形 1 つ分」の Execute にして IJobParallelFor にする
internal struct SkinningBroadPhaseJob : IJobParallelFor
{
    public void Execute(int triangleIndex) { /* skinning → faceNormal → broad-phase 判定 */ }
}

// 呼び出し側は「本数(triangleCount)」と「バッチサイズ」を渡して Schedule するだけ
JobHandle skinningHandle = skinningJob.Schedule(triangleCount, batchSize);
JobHandle clipHandle     = clipJob.Schedule(triangleCount, batchSize, skinningHandle); // 依存で連結

while (!clipHandle.IsCompleted) yield return null;  // 完了をポーリング(使い勝手は 1.x のまま)
clipHandle.Complete();
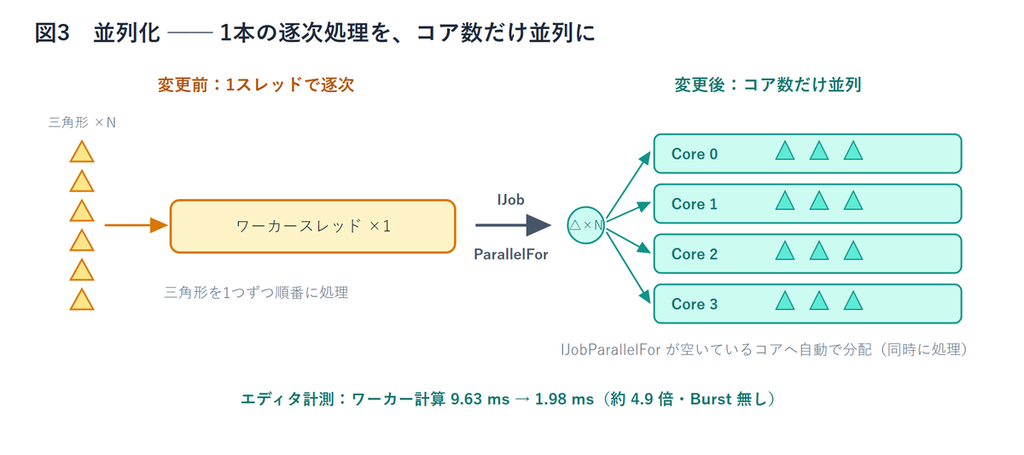
効果は、エディタ計測で ワーカー計算が約4.9倍(9.63ms → 1.98ms)。これはまだ後述の Burst を有効にする前、純粋に並列化しただけの数字です。ポリゴンが独立している分、コアの数だけ素直に効いてくれました。
なお、コルーチン側は「ジョブが終わったか」をポーリングするだけの作りに置き換えたので、外から見た使い勝手(AirStickerProjector の API や状態遷移)は 1.x と変わっていません。
Burst
仕上げが Burst です。Burst は Unity のジョブを LLVM で最適化されたネイティブコードにコンパイルし、SIMD(1命令で複数のデータをまとめて演算する仕組み)を効かせてくれます。ジョブに [BurstCompile] 属性を付けるだけで有効になります。
スキニングのボーン行列ブレンド、クリップの平面演算、タンジェント計算 ── いずれも数学中心のループなので、コンパイラがSIMD化しやすい処理となっています。
// 変更前:通常のジョブ(Mono / IL2CPP がそのまま実行)
internal struct SkinningBroadPhaseJob : IJobParallelFor
{
    public void Execute(int triangleIndex) { /* … */ }
}
// 変更後:[BurstCompile] を付けるだけ
[BurstCompile]
internal struct SkinningBroadPhaseJob : IJobParallelFor
{
    public void Execute(int triangleIndex) { /* ← LLVM がネイティブコード+SIMD にコンパイル */ }
}
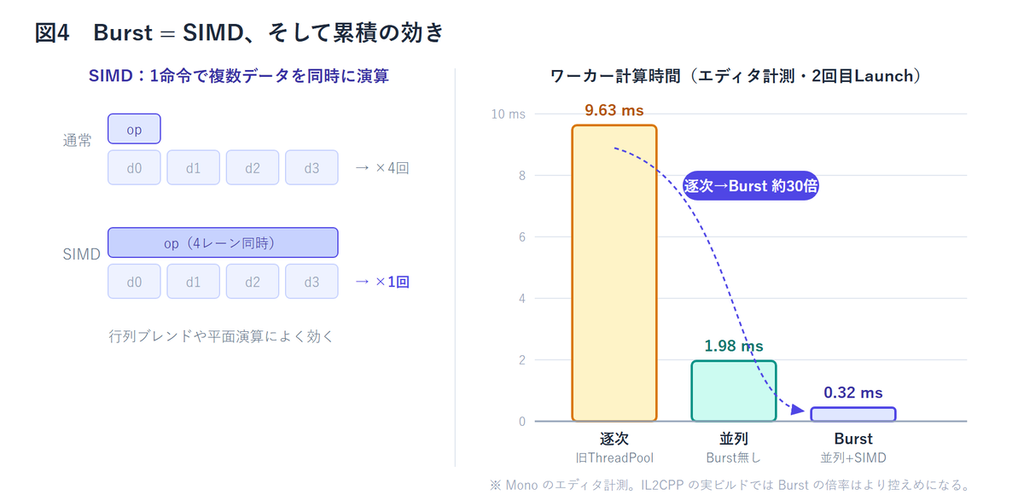
エディタ計測では、Burst の有無で ワーカー計算がさらに約6.3倍(2.02ms → 0.32ms)。並列化と合わせると、元の逐次処理からは 約30倍まで縮みました。
2.0 を使うには
2.0 はパフォーマンスのために内部を大きく作り替えたので、破壊的変更を含むメジャーアップデートです。
- 最小サポートを Unity 6.0 に引き上げました(1.x は Unity 2020.3〜)。Job System と Unity.Mathematics を前提に設計したためです。
- 依存パッケージに
com.unity.burstとcom.unity.mathematicsが加わりました(1.x は依存ゼロでした)。 - 内部実装だった一部の公開型(
ConvexPolygonなど)を削除しました。ただし、エントリーポイントであるAirStickerSystem/AirStickerProjectorの使い方は 1.x と変わりません。
旧 Unity をお使いの場合は、引き続き 1.x をご利用いただけます。導入は Package Manager から git URL で行えます(末尾に ?path=/Assets/AirSticker#2.0.0 を付与)。
最後に
今回は Air Sticker 2.0 のリリースにあわせ、デカール生成処理を Job System + Burst へ移行した最適化についてご紹介しました。
1本のスレッドで順番にこなしていた計算を、まずデータをSoAに組み替え、次に並列化し、最後に Burst対応 ── この3段階で、エディタ計測では約30倍の高速化が実現できました。
Air Sticker は MIT ライセンスのオープンソースとして公開しています。デカール表現をお探しの方は、ぜひ一度お試しください。皆様の開発の一助になれば幸いです。
[*1] 実機での Burst の効き方や AOT 設定の詳細は、リポジトリの CHANGELOG と README に記載しています。